
大小:3.18M 時長:18:31
引言
在企業軟體開發領域,Java 因其可靠性、可移植性和豐富的生態系統始終佔據著主導地位。
然而,當涉及到高性能計算(HPC)或數據密集型操作時,Java 的託管運行時和垃圾回收開銷給滿足現代應用的低延遲和高輸送量需求帶來了挑戰,尤其是當涉及即時分析、大規模日誌管道或深度計算的應用時。
與此同時,最初為渲染圖像而設計的圖形處理單元(GPU)已作為高效的計算加速器在眾多領域嶄露頭角。
像 CUDA 這樣的技術使開發人員能夠充分利用 GPU 的強大功能,為計算密集型任務帶來顯著的加速效果。
但這裡有一個問題:CUDA 主要是為 C/C++設計的,由於存在諸多集成方面的挑戰,Java 開發人員很少涉足這一領域。 本文旨在彌合這一差距。
我們將探討:
GPU 級加速對 Java 應用程式的意義;
併發模型之間的差異以及為什麼 CUDA 很重要;
將 CUDA 與 Java 集成的實用方法(JCuda、JNI 等);實際案例及性能基準測試;
確保企業級應用就緒的最佳實踐。
無論你是專注於性能優化的工程師,還是致力於探索下一代擴展技術的 Java 架構師,本指南都將為你提供極具價值的參考與指導。
理解核心概念:多線程、併發、並行和多處理
在深入探討 GPU 集成之前,有必要對 Java 開發人員通常使用的不同執行模型有一個清晰的瞭解。 這些概念常常被混為一談,但它們各自有著不同的含義。 理解它們之間的界限將有助於你更好地領略 CUDA 加速真正大放異彩之處。
多線程
多線程是指 CPU(或單個進程)在同一個記憶體空間內同時執行多個線程的能力。 在 Java 中,這通常是通過 Thread 和 Runnable 類,或者更高級的構造,如 ExecutorService 介面來實現的。 多線程的優點是線程輕量級且啟動速度快。 然而,由於所有線程共用同一個堆記憶體,這也帶來了一些限制,可能會引發諸如競態條件、死鎖以及線程爭用等一系列問題。
併發
併發是指以一種方式管理多個任務,使它們能夠隨著時間的推移取得進展,無論是在單個核心上交錯執行,還是跨多個核心並行運行。 可以將其視為一種對任務執行的協調方式,而不是試圖一次性完成所有任務。 Java 通過 java.util.concurrent 等包來支持併發。
並行
並行是指同時執行多個任務——與併發不同,併發可能涉及任務在時間上的交錯執行。 真正的並行需要硬體支援,例如多個 CPU 核心或執行單元。 儘管許多開發人員常常將線程與性能提升聯繫在一起,但真正的速度提升實際上取決於任務並行化的有效程度。 Java 通過一些工具(如 Fork/Join 框架)提供並行支援,但基於 CPU 的並行最終還是會受到核心數量以及上下文切換開銷的限制。
多處理
多處理是指運行多個進程,每個進程都擁有獨立的記憶體空間,這些進程可以在不同的 CPU 核心上並行執行。 與多線程相比,多處理具有更高的隔離性和穩健性,但其開銷也相對較大。 在 Java 中,真正的多處理通常需要啟動單獨的 JVM 或將工作負載分發給微服務處理。
那麼 CUDA 適合用在哪裡?
上述所有模型都嚴重依賴 CPU 核心,而 CPU 的數量最多只有幾十個。 相比之下,GPU 可以並行運行數千個羽量級線程。 CUDA 為你提供了利用這種大規模數據並行執行模型的能力,非常適合用於執行矩陣運算、圖像處理、批量日誌轉換或掩碼以及實時數據分析等任務。
這種細粒度的數據級並行幾乎是不可能通過標準的 Java 多線程實現的,而這就是 CUDA 帶來真正價值的地方。
CUDA 和 Java——現狀
傳統上,Java 開發人員面對的是 JVM 託管環境,遠離底層的硬體優化問題。 而 CUDA 則存在於一個截然不同的世界中,在這個世界里,通過精細管理記憶體、啟動數千個線程以及最大化 GPU 利用率來榨取性能。
那麼,這兩個世界如何實現交匯呢?
CUDA 是什麼?
計算統一設備架構(Compute Unified Device Architecture,CUDA)是英偉達推出的並行計算平臺和 API 模型,讓開發人員能夠為英偉達 GPU 上的大規模並行執行編寫軟體。 它通常與 C 或 C++ 搭配使用,開發人員需要編寫所謂的內核 ,也就是在 GPU 上並行運行的函數。
CUDA 在以下方面表現出色:
數據並行工作負載 (例如,圖像處理、金融類比、日誌轉換等);細粒度並行 ,可支持數千個線程;
計算密集型操作的加速時間顯著縮短 。
為什麼 Java 沒有進行原生適配?
Java 沒有原生支援 CUDA,因為:
JVM 無法直接訪問 GPU 記憶體或執行管道;
大多數 Java 庫都是以 CPU 和基於線程的併發模型為設計目標;
Java 的記憶體管理(垃圾回收、物件生命週期)對 GPU 不友好。
不過,藉助合適的工具與架構, 你可以實現 Java 與 CUDA 的橋接 ,從而在需要的地方解鎖 GPU 的加速潛力。
可用的集成選項
將 GPU 加速整合到 Java 中,有多種方法可選,但每種方法都需權衡利弊。
JCuda 是 CUDA 的 Java 綁定,提供了底層 API 和高級抽象(如 Pointer 和 CUfunction)。 它非常適合用於原型設計或實驗,但通常需要手動管理記憶體,這可能會限制其在生產環境中的使用。
Java 本地介面(JNI)允許你用 C++編寫 CUDA 內核並將其暴露給 Java,提供了更大的控制權和通常更好的性能。 雖然這種方法涉及更多的樣板代碼,但對於企業級集成來說,當更注重穩定性和細粒度資源控制時,這通常是首選方法。
Java 本地訪問(JNA)是 JNI 的一個更簡潔的替代方案,用於調用本地代碼,但它並不總是能夠為 CUDA 風格的工作負載提供所需的性能或靈活性。
還有一些新興的工具,如 TornadoVM、Rootbeer 和 Aparapi,它們通過使用位元組碼轉換或 DSL,為 Java 實現 GPU 加速提供了可能性。 這些工具適合用於研究和實驗,但可能不適合大規模生產環境。
實用的整合模式——在 Java 中調用 CUDA
為了更好地理解 Java 和 CUDA 在運行時是如何互動的,圖 1 展示了關鍵元件及其數據流。
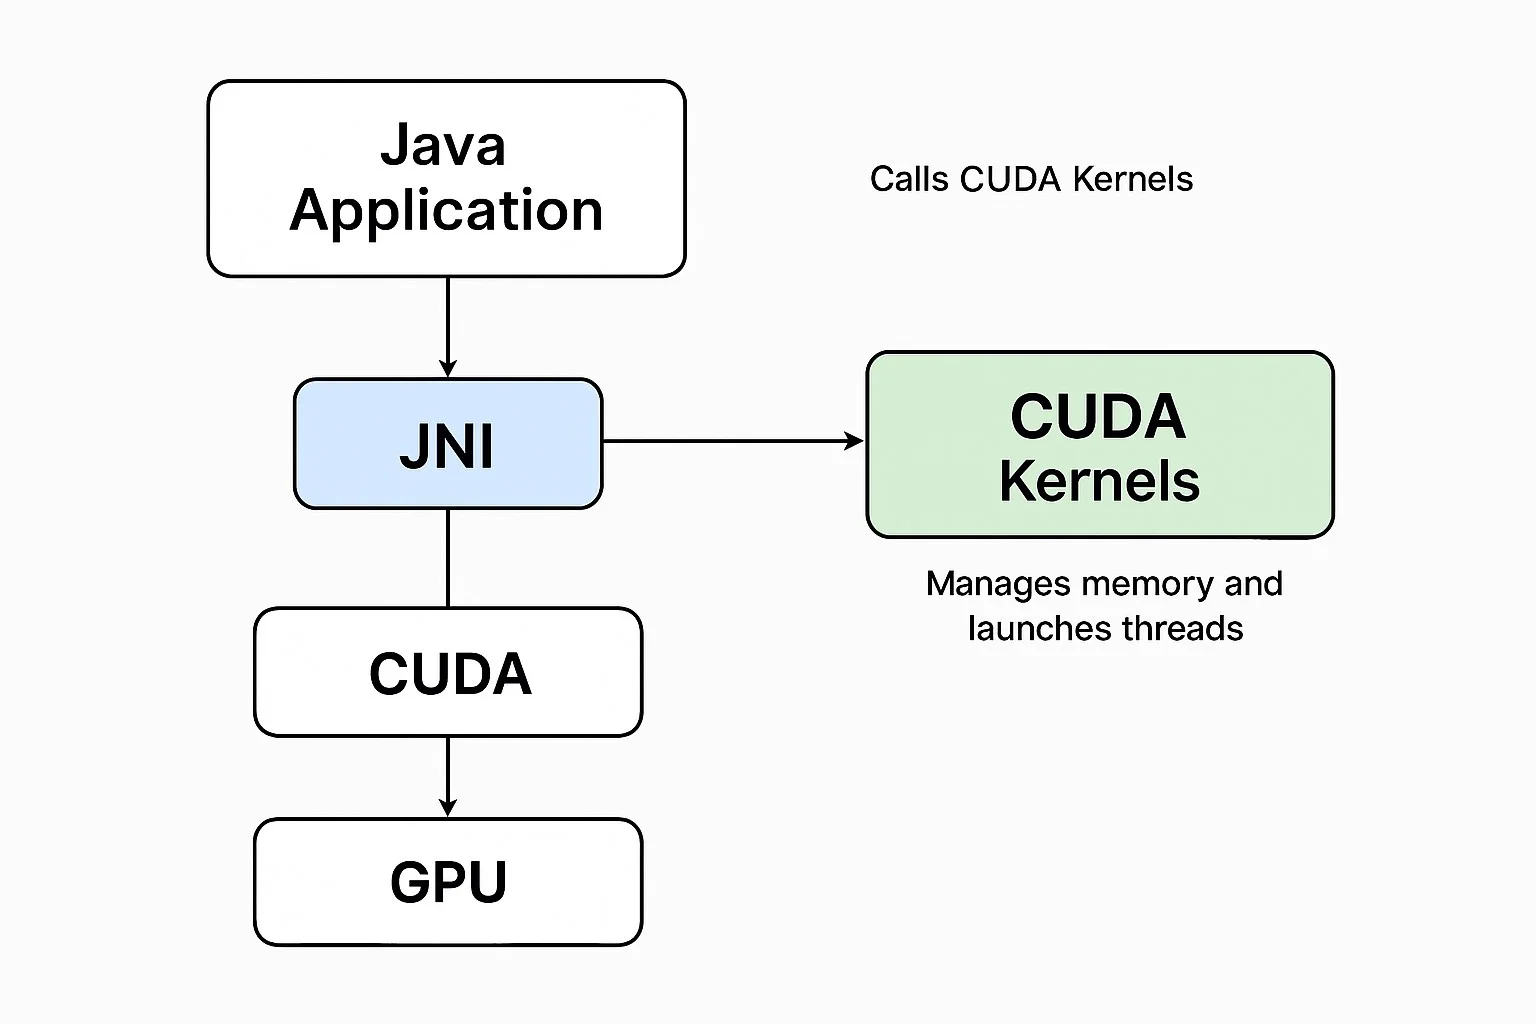
圖 1:通過 JNI 實現的 Java–CUDA 集成架構
我們已經對架構進行了可視化,接下來讓我們來分析每個元件在實際運行中是如何協同工作的。
Java 應用層
這是你的標準 Java 服務,可能是一個日誌框架、分析管道或任何高輸送量的企業模組。 它不再僅僅依賴線程池或 Fork/Join 框架來實現併發,而是通過原生調用將計算密集型工作負載卸載到 GPU 上。
在這一層,Java 負責準備輸入數據,觸發對本地後端的 JNI 調用,並將結果重新整合到主應用程式流程中。 例如,你可能會將每秒數千個用戶會話的 SSH 式加密或安全密鑰哈希卸載到 GPU 上,從而釋放 CPU,使其專注於 I/O 和協調工作。
JNI 橋接層
JNI 充當 Java 與包含 CUDA 邏輯的本地 C++程式碼之間的橋樑。 它負責聲明本地方法,載入共用的本地庫(如.so 或.dll 檔),並在 Java 堆和本地緩衝區之間傳遞記憶體。 在大多數情況下,使用原始數位可以高效地傳輸數據。
在這一層,必須格外小心地處理記憶體管理和類型轉換(例如,將 jintArray 轉換為 int*)。 這裡的錯誤可能導致段錯誤或記憶體洩漏,因此防禦性程式設計和資源清理至關重要。 此外,這一層通常還包含日誌記錄和驗證邏輯,以防止不安全操作被傳播到 GPU 級別。
CUDA 內核(C/C++)
這裡就是並行展現魔法的地方。 CUDA 內核是羽量級的 C 風格函數,專為在數千個 GPU 線程上同時運行而設計。 內核使用 CUDA C API 撰寫在 .cu 檔中,並通過熟悉的 <<<blocks, threads>>> 語法啟動。
每個內核都在 JNI 層傳遞下來的緩衝區上進行操作,並對它們執行大規模並行處理,無論是加密字串、哈希位元組數位還是應用矩陣變換。 共用記憶體和全域記憶體被用於加速處理,數據在原地處理以避免不必要的傳輸。 例如,可以並行地將 SHA-256 或 AES 加密邏輯應用於整個批次的會話令牌或文件負載。
GPU 執行
一旦內核啟動,CUDA 將負責處理線程調度、隱藏記憶體延遲以及基本同步。 不過,性能優化仍然需要通過手動基準測試和細緻的內核配置來實現。
將 CUDA 集成到 Java 中的開發人員必須注意塊和線程的大小,盡量減少記憶體複製瓶頸,並確保使用 CUDA API(如 cudaGetLastError() 或 cudaPeekAtLastError())進行適當的錯誤處理。 這一層在開發過程中通常是不可見的,但在運行時性能和故障隔離方面發揮著關鍵作用。
返回流程
處理完成後,結果(例如,加密金鑰、計算後的陣列)會返回到 JNI 層,然後被轉發到 Java 應用程式進行進一步處理,無論是保存到資料庫中、發送給下游還是在 UI 上顯示。
集成步驟總結
為你的邏輯編寫 CUDA 內核;
創建暴露內核並支援 JNI 綁定的 C/C++包裝器;
使用nvcc編譯並生成 Linux 的.so檔或 Windows 的.dll檔;
編寫帶有本地方法的 Java 類,並通過System.loadLibrary()載入庫;
在 Java 和本地代碼之間優雅地處理輸入/輸出和異常。
企業用例——使用 Java 和 CUDA 進行大規模批量數據加密
為了展示在 Java 環境中實現 GPU 加速的實際效果,我們來分析一個實際的企業場景: 大規模批量數據加密 。 許多後端系統需要頻繁處理敏感資訊,例如使用者憑據、會話令牌、API 密鑰以及文件內容等。 這些數據通常需要進行哈希或加密操作,且往往是在高輸送量的場景下進行。
傳統上,Java 系統依賴 CPU 密集型的庫(如 javax.crypto 或 Bouncy Castle)來執行這些操作。 雖然這些庫很有效,但在需要每小時處理數百萬條記錄或要求低延遲回應的環境中,它們可能會力不從心。 此時,利用 CUDA 加速的並行處理能力就成為了一個頗具吸引力的替代方案。
GPU 特別適合處理這種工作負載 ,因為加密或哈希邏輯(例如 SHA-256)是無狀態的、統一的,並且高度可並行化。 不需要線程間通信,並且內核操作可以高效地批量處理。 在某些情況下,與單線程的 Java 實現相比,延遲可以降低多達五十倍。
為了驗證這種方法,我們構建了一個簡單的原型管道:Java 層準備一個包含用戶數據條目或會話令牌的陣列,並通過 JNI 將其傳遞給本地 C++層。 隨後,一個 CUDA 內核對數位中的每個元素應用 SHA-256 哈希。 處理完成後,結果以位元組陣列的形式返回到 Java 層,準備好進行安全傳輸或存儲。
性能對比
免責聲明 :這些是合成的基準數位,僅用於說明目的。 實際結果可能會因硬體配置和優化調整而有所不同。
實際的好處
將加密工作負載卸載到 GPU 上,可以釋放出 CPU 資源,用於處理應用邏輯和 I/O,這使其非常適合用於高輸送量的微服務架構中。 這種模式特別適用於安全 API 閘道、文件處理管道以及任何需要大規模進行數據認證或哈希的系統。 批量處理也變得更加高效,每個內核都可以輕鬆地對數萬個記錄進行哈希,實現真正的並行安全操作。
最佳實踐與注意事項——讓 Java + CUDA 生產就緒
將 Java 與 CUDA 集成,性能上升到了一個新的層級,但這種強大的能力也帶來了相應的複雜性。 如果你計劃基於這一技術棧構建企業級系統,有一些關鍵的考量因素可以確保你的解決方案既可靠又可維護,同時保障安全性。
記憶體管理
與 Java 的垃圾回收機制不同,CUDA 需要顯式地進行記憶體管理。 如果忘記釋放 GPU 記憶體,不僅會導致記憶體洩漏,還可能迅速耗盡顯存,進而在高負載下引發系統崩潰。
使用 cudaMalloc() 和 cudaFree() 這兩個函數來顯式管理 GPU 記憶體,它們都定義在 CUDA Runtime API (cuda_runtime.h) 中。 確保每個 JNI 入口點都有對應的清理步驟。
在典型的集成場景中,這些方法被封裝在本地 C++層中,並通過 JNI 暴露給 Java。 例如,你的 Java 類可能會定義一個本地方法,如 public native long cudaMalloc(int size) ,它在 C++中調用實際的 cudaMalloc(),並將設備指標作為 long 返回給 Java。
或者,開發人員可以使用 JCuda 或 JavaCPP CUDA 之類的預設庫,直接從 Java 訪問 CUDA 功能,無需手動編寫 JNI 代碼。 這些庫提供了與 CUDA C API 直接對應的 Java 包裝器和類定義,簡化了在 JVM 內的記憶體管理和內核啟動過程。
Java 與本地代碼之間的數據封送
在 Java 和 C/C++之間通過 JNI 傳遞數據,絕非僅僅是語法問題,若處理不當,極易成為嚴重的性能瓶頸。 應堅持使用原始數位(int[]、float[] 等),而不是複雜的 Java 物件,並使用 GetPrimitiveArrayCritical() 以低延遲、GC 安全的方式訪問本地記憶體。 同時,需要小心處理字串編碼差異。 Java 內部使用的是修改過的 UTF-8,若處理不當,可能會破壞與標準 C 風格字串的相容性。 為了最小化開銷,建議一次性分配本地緩衝區,並在重複調用中重複使用這些緩衝區。
線程安全
大多數 Java 服務是多線程的,這在調用本地代碼時帶來了潛在風險。 GPU 流和 JNI 句柄不應跨線程共用,除非進行了明確的同步。 相反,應設計無狀態的 JNI 介面,並在併發啟動 GPU 內核時依賴線程本地緩衝區。 雖然 Java 的同步塊可以提供説明,但應謹慎使用,因為它們可能會引入競爭條件。 清晰地分離狀態和每個線程的資源,通常會帶來更安全、更可擴展的 GPU 集成。
測試和調試本地代碼
與 Java 異常不同,本地 C++或 CUDA 代碼中發生的崩潰可能會導致整個 JVM 終止。 這使得測試和調試至關重要且更具挑戰性。 始終使用 CUDA 的錯誤檢查 API,如 cudaGetLastError() 和 cudaPeekAtLastError(),以便儘早捕獲靜默失敗。 在早期開發階段,將所有本地步驟的日誌記錄到單獨的檔中,以便隔離問題,避免將它們混入應用程式日誌中。 保持 CUDA 內核的模組化,並在從 Java 調用它們之前,用 C++編寫本地單元測試,有助於在它們影響整個系統之前捕獲底層的錯誤。
安全性和隔離性
在處理敏感工作負載(如加密、令牌生成或密鑰派生)時,本地代碼必須被視為潛在威脅的一部分。 確保在 Java 端進行驗證輸入,然後再調用 JNI。 避免在 CUDA 內核中進行動態記憶體分配,以減少不可預測的行為。 盡可能減少本地模組中的依賴項,以縮小攻擊面。
提示 :為了實現更好的隔離效果,可以將本地代碼運行在沙箱容器(例如,具有 GPU 訪問許可權的 Docker)中,這樣既能限制系統暴露風險,又能提升可審計性
部署和可移植性
部署 GPU 加速的本地代碼不只是打包一個 JAR 那麼簡單。 你還需要處理 GPU 驅動程式相容性問題、CUDA 運行時的依賴項、本地庫的連結(.so, .dll)以及應對不同作業系統之間的差異。 如果這些細節管理不當,很容易導致不同環境之間出現碎片化的問題。
為了確保一致性和可移植性,建議使用構建工具(如 CMake)並結合 nvidia-docker 對你的部署進行容器化,從而在開發和生產環境中保持一致的 CUDA 版本和系統庫。
總結清單——讓 Java + CUDA 企業就緒
這是一個關於生產級最佳實踐的快速參考總結:
記憶體管理 :正確使用cudaMalloc()/cudaFree(),手動管理記憶體以防止洩漏。 盡可能重用已分配的記憶體。
JNI 橋接 :保持 JNI 層線程安全和無狀態。 優先使用原始數位進行封送。
測試 :使用模組化的 CUDA 內核,並使用cudaGetLastError()或類似的診斷工具驗證每個步驟。
安全性 :在將輸入傳遞給本地代碼之前,始終在 Java 端進行清理和驗證。 限制 C++中的依賴項,以減小攻擊面。
部署 :進行容器化(例如,nvidia-docker),並確保在不同環境中保持一致的 CUDA 版本和驅動程式。
結論和下一步
Java 和 CUDA 的結合可能不是主流,但若運用得當,它能為企業系統解鎖一個全新的性能層級。 無論你是需要每秒處理數百萬條記錄、卸載安全計算任務,還是構建近即時的分析管道,GPU 加速所帶來的速度提升都是單純依靠 CPU 所難以企及的。
在這篇指南中,我們探討了如何通過理解併發、並行和多處理之間的基礎差異,來彌合 Java 與 CUDA 之間的差距。 我們介紹了 JNI 與 CUDA 的實用整合模式,並通過一個合成的加密用例基準測試,展示了性能提升的效果。 最後,我們還提到了企業級最佳實踐,確保記憶體安全、運行時穩定性、可測試性以及跨環境部署的可移植性。
為什麼這很重要
Java 開發人員不再局限於線程池和執行服務。 通過與 CUDA 集成,你可以突破 JVM 核心數量的限制,將高性能計算(HPC)風格的執行引入標準企業系統,而無需重寫整個技術棧。
下一步
在即將發佈的文章中,我們將探索:
Java 中的混合 CPU-GPU 調度模式 ;
使用 Java 綁定在 GPU 上進行基於 ONNX 的 AI 模型推理 ;
使用 Foreign Function & Memory API (JEP 454),該 API 旨在取代 JNI,為調用本地庫提供了一種更安全、更現代的方法。 隨著它的不斷發展,可能會顯著簡化並改善 Java 與 CUDA 之間的互操作性。
【聲明:本文由 InfoQ 翻譯,未經許可禁止轉載。 】
查看英文原文:https://www.infoq.com/articles/cuda-integration-for-java/
大會推薦:
8 月 22~23 日的 AICon 深圳站 將以 “探索 AI 應用邊界” 為主題,聚焦 Agent、多模態、AI 產品設計等熱門方向,圍繞企業如何通過大模型降低成本、提升經營效率的實際應用案例,邀請來自頭部企業、大廠以及明星創業公司的專家,帶來一線的大模型實踐經驗和前沿洞察。 一起探索 AI 應用的更多可能,發掘 AI 驅動業務增長的新路徑!
騰訊雲雲原生提質增效實踐精選集 2024
《2024騰訊雲雲原生提質增效實踐精選集》出爐,5大熱門技術領域,13個行業精選標杆案例,痛點到解決方案全...
京東中台業務架構敏捷性方法 MotriDSP 落地實踐





評論